Modders desbloqueiam desempenho oculto de IA em placas GeForce RTX antigas
Projetos experimentais para RTX 20, 30 e 40 ampliam a taxa de operações em alguns testes, mas não prometem acelerar jogos nem chatbots da mesma forma.
Placas de vídeo GeForce não foram feitas apenas para games: seus núcleos Tensor também são importantes para inteligência artificial. Uma série de projetos independentes mostrou que determinadas operações matemáticas estavam limitadas por configurações que podem ser alteradas. Os experimentos atingem GPUs RTX 20, RTX 30 e RTX 40, com aumentos expressivos em benchmarks de multiplicação de matrizes — embora o benefício para aplicações reais varie bastante.
A investigação publicada pelo TechSpot em 27 de outubro descreve ferramentas de código aberto que ajustam registros ligados à emissão de instruções Tensor. Isso não transforma automaticamente uma GeForce numa GPU profissional nem garante que qualquer programa de IA passará a funcionar duas vezes mais rápido.
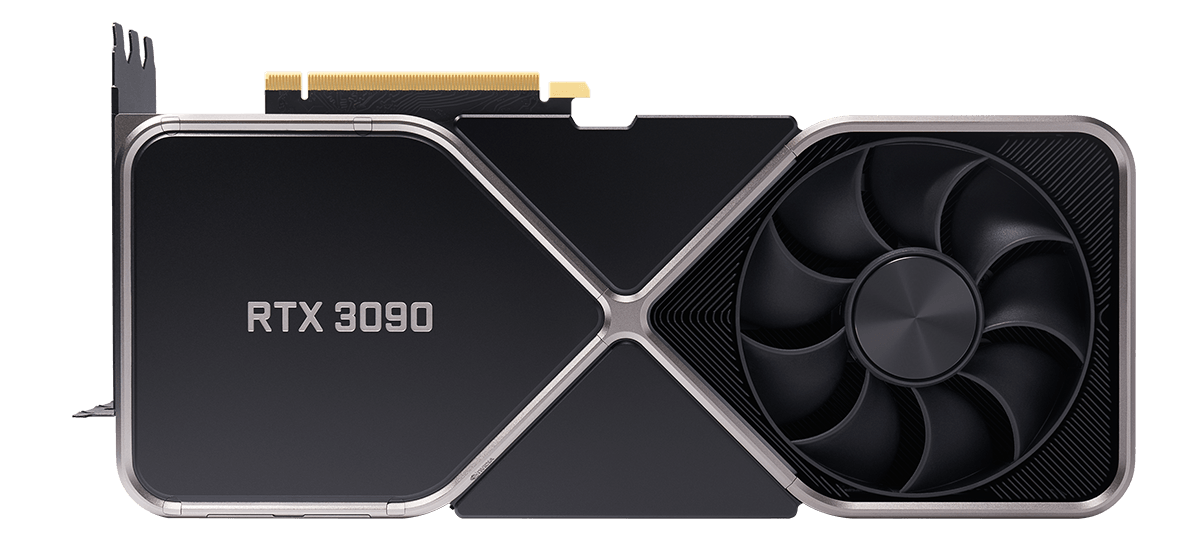
A RTX 3090 virou peça-chave dos entusiastas
Os 24 GB de VRAM tornam a placa atraente para modelos locais. O limite de certas operações de precisão mista, porém, pode reduzir o aproveitamento dos núcleos Tensor em cargas específicas.
O que está sendo desbloqueado?
Os Tensor Cores são unidades especializadas em cálculos matriciais. Uma operação comum utiliza números FP16 ou BF16 como entrada e acumula resultados em FP32 para preservar precisão. Em determinadas gerações GeForce, esse modo opera com uma taxa de emissão de instruções menor do que a encontrada em placas profissionais relacionadas.
O projeto gpu-unlock, de Zagitta, atua durante a inicialização do driver Nvidia em sistemas Linux, ajustando registradores da placa antes de o driver assumir o controle. O objetivo é remover a limitação de taxa em operações específicas. Há também variações para Ada Lovelace e Turing, cada uma adaptada a GPUs e instruções diferentes.
RTX 3090 Ti: ganho relatado em um teste de BF16
Taxa de processamento matemático medida pelo desenvolvedor, em TFLOPS; não representa FPS de jogos ou tokens por segundo.
Quais atividades podem melhorar?
Operações matriciais intensivas podem aproveitar parte do ganho, dependendo de como o framework foi configurado.
Testes relatam ganhos menores, da ordem de 14% a 36%, conforme modelos e hardware.
A velocidade de tokens pode mudar pouco porque costuma depender fortemente da largura de banda da memória.
O caso de uma RTX 4090 ilustra a diferença entre benchmark e uso real. A taxa bruta de instruções FP16 praticamente dobrou numa demonstração, mas testes de multiplicação de matrizes por proprietário independente encontraram melhoras menores, entre cerca de 12% e 34%. O gargalo migra conforme a tarefa, a precisão numérica e a movimentação dos dados.
Isso aumenta os FPS em games?
Praticamente não. Jogos usam as unidades Tensor para certas técnicas, mas o tipo de operação desbloqueado não corresponde à maior parte do trabalho de renderização. Também não é um atalho garantido para DLSS ou ganhos gerais em CUDA. A notícia interessa principalmente a quem trabalha com IA local e tem hardware de gerações anteriores.
Os módulos são experimentais, dependem de versão do sistema e driver e podem introduzir instabilidade. Há alertas sobre consumo e temperatura de núcleos Tensor. Não é recomendável aplicar mudanças em máquinas de produção ou servidores sem entender os riscos e dispor de recuperação.
Como cada geração entra nessa história
Projetos e resultados em perspectiva
O gpu-unlock demonstra aumento em BF16 e modos de acumulação FP32 em placas Ampere.
Uma variante para Ada Lovelace amplia a emissão de operações FP16, mas a melhora real é menor e depende do teste.
O turing-unlock experimenta otimizações para a RTX 2080 Ti. BF16 não é aplicável à geração Turing.
Outro detalhe importante: a maior parte dos experimentos foi desenvolvida para Linux. Portes experimentais para Windows não equivalem a suporte universal. Além disso, o desempenho muda conforme bibliotecas, versões de drivers, kernels e estruturas matemáticas utilizadas por cada projeto de IA.
Uma segunda vida para hardware caro
O uso de placas antigas em laboratórios domésticos tornou-se atraente porque modelos de IA locais dependem tanto de VRAM quanto de poder computacional. Recuperar desempenho de núcleos Tensor pode ampliar as possibilidades de treinamento e processamento de imagens em equipamentos que já estão em circulação.
Mas ganhos expressivos exigem contexto. Sem medições consistentes de consumo, temperatura, estabilidade e performance real, não há base para vender o desbloqueio como solução universal. A evolução dos projetos será mais interessante se os resultados forem reproduzíveis por pesquisadores independentes.
Veredicto GeekZilla
É fascinante descobrir capacidade não aproveitada em placas GeForce de gerações passadas. Para IA local, os experimentos merecem atenção; para gamers, não há milagre. A notícia é sobre pesquisa e otimização de workloads específicos — não uma atualização mágica que dobra o desempenho de qualquer RTX.