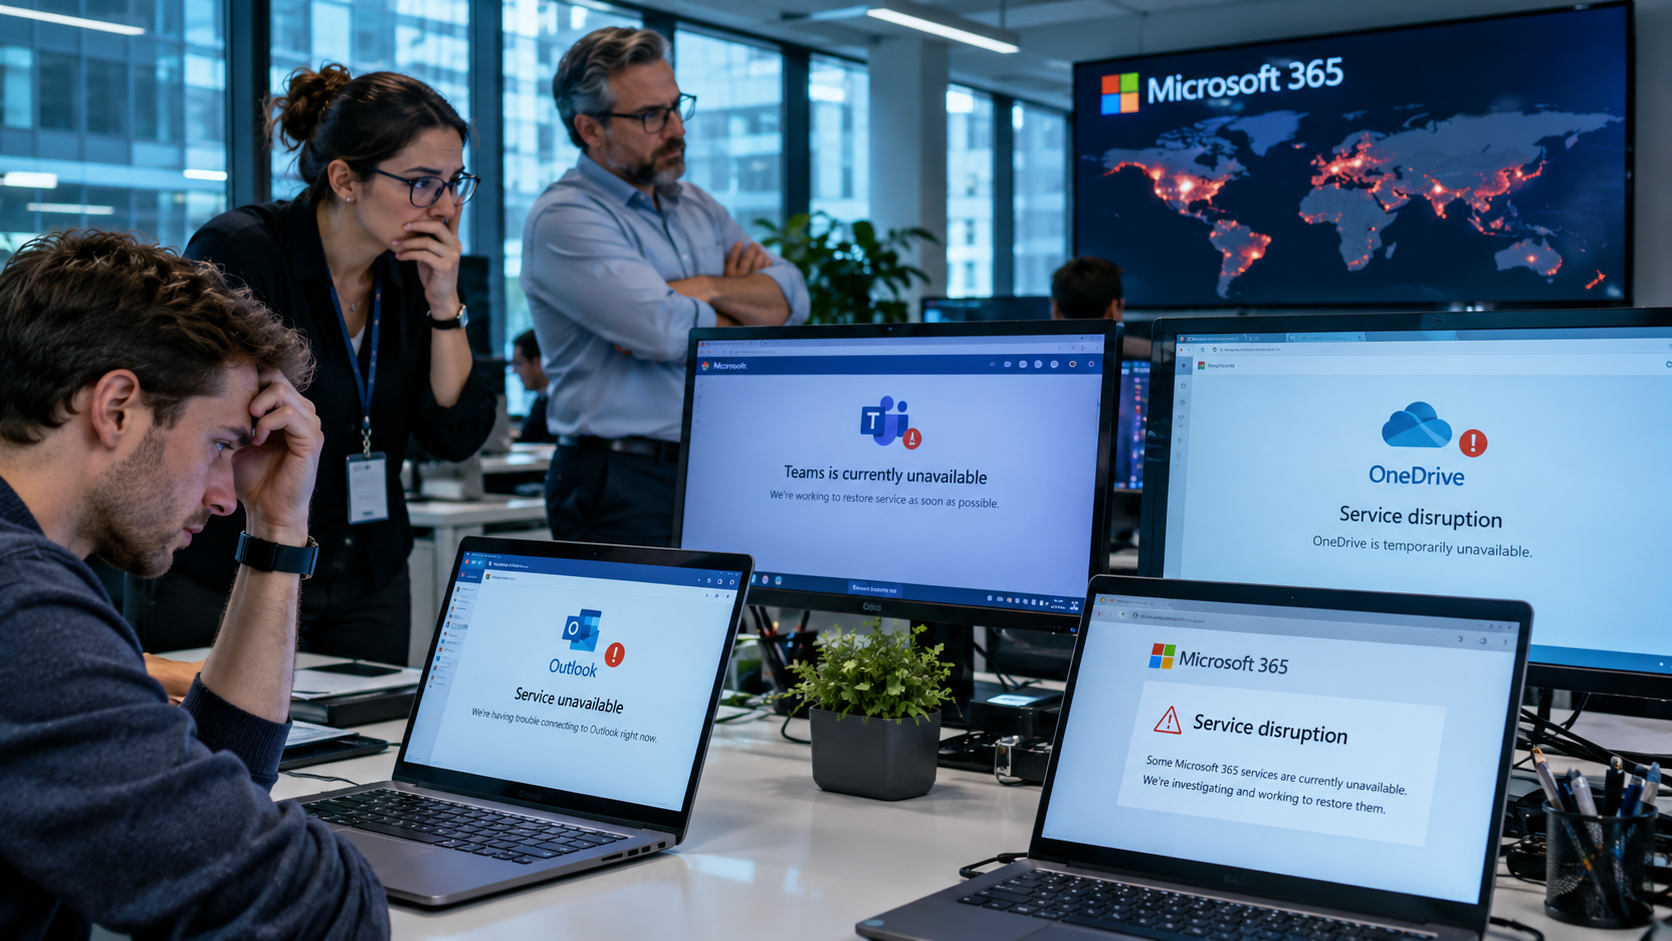
Uma falha em infraestrutura de nuvem mostrou nesta semana que o botão de enviar e-mail ainda sustenta parte considerável do mundo moderno. A interrupção do Microsoft 365 iniciada em 12 de novembro de 2026 afetou Outlook, Teams, Copilot e serviços corporativos associados, atingindo usuários, empresas e instituições públicas em diferentes países. A Microsoft relatou problemas técnicos de capacidade e recuperação gradual, sem evidências de ataque cibernético. A pane atravessou a quinta-feira e continuou produzindo efeitos na sexta, dia 13, quando a empresa informou avanços na estabilização.
Os serviços sofreram problemas técnicos de disponibilidade. A empresa descartou indícios de ação maliciosa; interrupção de serviços não equivale a vazamento ou comprometimento de dados.
Uma queda global com efeitos bastante concretos
Falhas em plataformas de produtividade costumam ser descritas como se fossem apenas inconvenientes de escritório. Só que e-mails e reuniões digitais também fazem parte de processos em hospitais, órgãos públicos, companhias aéreas, escritórios de advocacia, bancos e universidades. Quando serviços de autenticação, mensagens e colaboração param de responder, decisões ficam atrasadas e equipes precisam improvisar outros canais. A interrupção atingiu diferentes regiões do planeta, com relatos de instabilidade no Outlook, Exchange Online, Teams e Copilot. Nem todos os usuários ou produtos foram afetados da mesma forma, detalhe importante para não transformar o evento numa afirmação falsa de que toda a Microsoft saiu do ar.
O que a Microsoft explicou sobre a causa
Os comunicados acompanhados por veículos internacionais apontaram problemas técnicos em servidores e infraestrutura, incluindo sobrecarga e dificuldades durante a recuperação de capacidade após alterações na rede. A empresa descartou indícios de ação maliciosa e relatou medidas para controlar o tráfego e recuperar máquinas. Houve momentos em que servidores reiniciados voltavam a enfrentar problemas quando recebiam carga, complicando a estabilização. Isso ajuda a entender por que desligar e ligar serviços de uma escala tão grande não resolve automaticamente o incidente. Uma recuperação precisa devolver capacidade sem reproduzir a mesma situação de saturação.
Por que a recuperação leva horas
Serviços distribuídos não se comportam como um computador doméstico que pode ser reiniciado à vontade. O retorno envolve bancos de dados, filas de mensagens, equipamentos de rede, roteamento e múltiplas regiões que processam cargas enormes. É possível que alguém consiga abrir uma caixa de entrada enquanto outro ainda não envia mensagens. Também podem existir atrasos de entrega mesmo depois de o painel principal parecer recuperado. Por isso, falar em normalização completa exige cautela: comunicados sobre melhoria de disponibilidade não significam automaticamente encerramento de todas as falhas ou recuperação instantânea dos e-mails acumulados.
Quantos usuários foram afetados?
Plataformas como o Downdetector registraram picos expressivos de reclamações, mas esse tipo de dado mede relatos de problemas, não um censo confiável de usuários únicos atingidos. Diferentes notificações podem partir da mesma pessoa, e o número de reclamações tende a subestimar organizações que enfrentam problemas mas não registram incidentes publicamente. A dimensão da crise ficou clara pela variedade de instituições envolvidas, não pela tentação de converter cada contagem de relatórios em uma audiência diretamente atingida. Qualquer estimativa de prejuízo financeiro também depende de metodologia e precisa ser tratada como projeção, não como fatura fechada.
A dependência de um único provedor
O episódio reacendeu uma discussão que aparece a cada grande pane de nuvem: até que ponto é saudável concentrar mensagens, identidade, documentos e colaboração em um único conjunto de serviços? A integração tem vantagens reais de administração, segurança e custo, principalmente para equipes pequenas. Mas também aumenta a área de impacto quando uma infraestrutura compartilhada apresenta defeito. Não significa que empresas devam abandonar toda plataforma integrada nem que uma solução concorrente seria imune. Significa reconhecer que conveniência e resiliência precisam ser planejadas separadamente.
O que equipes de TI podem aprender
Ter contatos de emergência fora da plataforma principal, documentar procedimentos de contingência e manter meios alternativos de comunicação são medidas mais úteis do que simplesmente culpar a nuvem. Organizações podem revisar dependências críticas, como alertas enviados apenas por e-mail corporativo, acessos administrativos ligados a um mesmo fornecedor e processos que exigem uma única ferramenta online. Backups protegem informações, mas nem sempre oferecem continuidade operacional imediata. A pergunta correta durante um incidente é: o que precisa funcionar mesmo quando a interface habitual desaparece?
Segurança e informação sem alarmismo
Um serviço indisponível não é sinônimo de dados comprometidos. A Microsoft informou não ter identificado atividade maliciosa como causa da interrupção, e não há base para afirmar que houve vazamento por causa da pane. Misturar problemas de disponibilidade com ataques cibernéticos só gera confusão. Ao mesmo tempo, indisponibilidade prolongada pode ter consequências graves e merece investigação técnica transparente. Uma análise pós-incidente consistente deve explicar sequência de eventos, mecanismos de falha, alcance, medidas corretivas e o que será alterado para reduzir a probabilidade de repetição.
O ponto é contingência: comunicações alternativas, mapa de dependências e procedimentos para continuar operando durante uma falha de fornecedor. Ter tudo integrado não equivale a ter tudo protegido contra indisponibilidade.
Veredicto GeekZilla
A pane do Microsoft 365 lembra que a infraestrutura invisível continua sendo parte decisiva da nossa rotina. Uma falha de capacidade pode atravessar setores inteiros e atingir organizações que nunca imaginaram depender da mesma plataforma ao mesmo tempo. A Microsoft terá de demonstrar não apenas que recuperou os sistemas, mas que aprendeu com a cadeia de eventos.
Para administradores de redes e gestores, o recado é claro: a nuvem pode ser excelente e ainda assim falhar. O que separa um contratempo de uma crise operacional é a preparação anterior. E quem promete disponibilidade perfeita em qualquer arquitetura provavelmente está vendendo marketing, não engenharia.