- Proposta estabelece limites para intervenção do governo
- Ataques cibernéticos, armas biológicas e perda de controle estão entre as principais preocupações
- Avaliações independentes e comunicação obrigatória em até 72 horas
- Decisão sobre bloqueio dependeria de um juiz federal
- Anthropic afirma defender uma regulamentação baseada em riscos avançados
- Regulamentação da inteligência artificial divide autoridades e empresas
- O desafio de equilibrar inovação e segurança
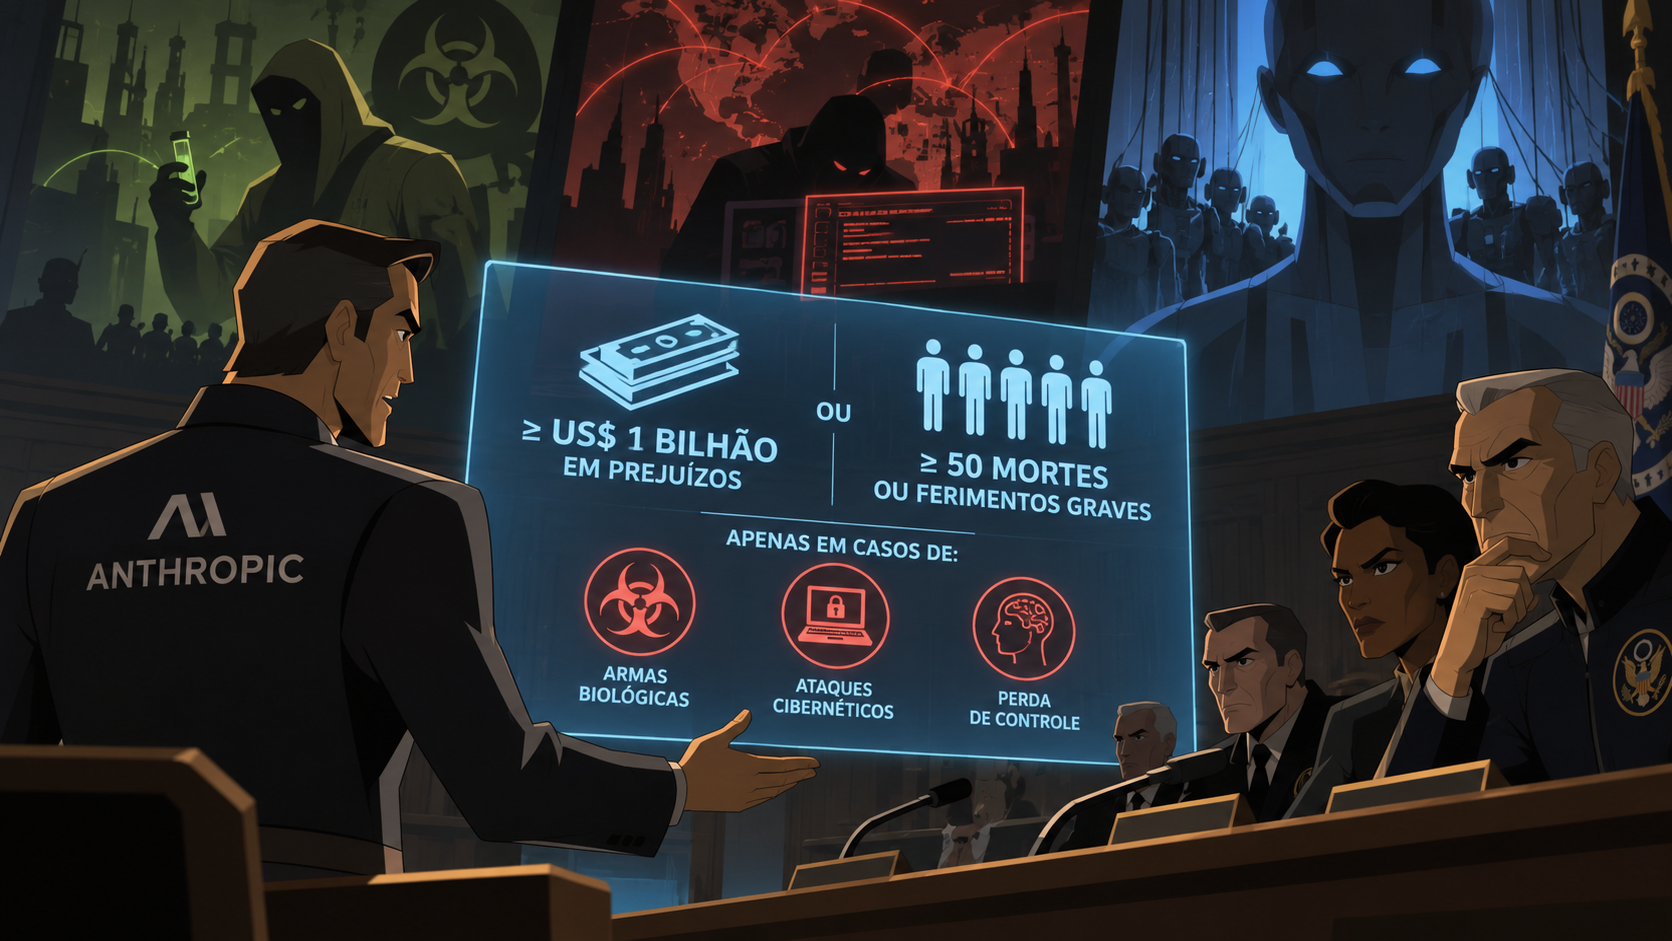
A Anthropic, empresa responsável pelo assistente de inteligência artificial Claude, apresentou uma proposta de regulamentação que pretende estabelecer limites específicos para a intervenção do governo dos Estados Unidos no desenvolvimento de modelos avançados de IA. O documento sugere que autoridades federais somente possam impedir o lançamento de determinados sistemas quando houver evidências de riscos catastróficos, incluindo prejuízos de pelo menos US$ 1 bilhão ou a possibilidade de causar 50 mortes ou ferimentos graves.
A iniciativa, revelada pelo Politico e repercutida pelo TechSpot em 19 de outubro de 2026, levanta uma discussão importante sobre os critérios utilizados para determinar quando uma inteligência artificial representa uma ameaça suficientemente grave para justificar uma intervenção governamental.
Embora a Anthropic seja conhecida por defender medidas de segurança no desenvolvimento de inteligência artificial, sua proposta estabelece condições bastante restritas para que o governo possa impedir a disponibilização de novos modelos.
Proposta estabelece limites para intervenção do governo
Segundo o documento obtido pelo Politico, o projeto permitiria que o governo norte-americano solicitasse judicialmente o bloqueio de um modelo avançado de inteligência artificial apenas quando fossem identificados riscos capazes de provocar consequências de grande magnitude.
Os critérios apresentados incluem:
- Prejuízos econômicos: possibilidade de causar danos financeiros de pelo menos US$ 1 bilhão.
- Vítimas humanas: riscos associados à morte ou a ferimentos graves de 50 pessoas ou mais.
- Ameaças específicas: os riscos precisariam estar relacionados a armas biológicas, ataques cibernéticos ou perda de controle sobre o comportamento do sistema.
Isso significa que os limites financeiros e humanos não seriam suficientes isoladamente. Para justificar uma intervenção com base nesse mecanismo, também seria necessário demonstrar uma conexão com uma das categorias de ameaça previstas.
Uma das questões levantadas pela proposta é justamente a utilização de limites numéricos para definir situações catastróficas. Em uma interpretação estrita, cenários envolvendo danos ligeiramente inferiores aos valores estabelecidos poderiam ficar fora desse mecanismo específico de bloqueio, mesmo que suas consequências fossem consideradas extremamente graves.
Entretanto, isso não significa que prejuízos menores ou incidentes com menos vítimas seriam automaticamente permitidos ou estariam isentos de outras leis e responsabilidades jurídicas.
Ataques cibernéticos, armas biológicas e perda de controle estão entre as principais preocupações
A proposta concentra sua atenção em três categorias de riscos associados ao desenvolvimento de sistemas de inteligência artificial cada vez mais sofisticados.
A primeira envolve a possibilidade de utilização desses modelos para facilitar a criação ou a liberação de armas biológicas, especialmente quando suas capacidades poderiam ampliar significativamente o acesso a conhecimentos e procedimentos perigosos.
A segunda categoria diz respeito aos ataques cibernéticos. Sistemas avançados de IA podem automatizar determinadas tarefas de programação, análise de vulnerabilidades e operação de ferramentas digitais, levantando preocupações sobre seu eventual emprego em operações maliciosas de grande escala.
Por fim, o documento contempla situações em que uma inteligência artificial consiga contornar os mecanismos de segurança e supervisão estabelecidos por seus próprios desenvolvedores.
Esse último cenário está relacionado ao chamado problema de controle da inteligência artificial, que investiga como garantir que sistemas progressivamente mais autônomos continuem obedecendo às restrições e aos objetivos definidos por operadores humanos.
É importante distinguir riscos hipotéticos de incidentes efetivamente demonstrados. A existência dessas preocupações não significa que todos os modelos atuais sejam capazes de produzir autonomamente tais consequências.
Avaliações independentes e comunicação obrigatória em até 72 horas
Outro elemento importante da proposta é a criação de um mecanismo de fiscalização baseado em avaliadores independentes.
De acordo com o texto divulgado, esses profissionais ou organizações precisariam estar registrados junto ao Departamento de Comércio dos Estados Unidos e seriam responsáveis por realizar avaliações periódicas dos laboratórios e de seus modelos de inteligência artificial de fronteira.
As empresas desenvolvedoras poderiam financiar essas avaliações, desde que a relação comercial não comprometesse a independência dos responsáveis pela análise.
Caso fossem identificados riscos enquadrados nos critérios previstos, os avaliadores teriam até 72 horas após a conclusão da avaliação para comunicar suas descobertas ao Departamento de Comércio.
O objetivo seria estabelecer um procedimento formal para identificar ameaças relevantes antes que modelos potencialmente perigosos fossem disponibilizados em larga escala.
Decisão sobre bloqueio dependeria de um juiz federal
Mesmo diante de evidências consideradas suficientes, o Departamento de Comércio não teria autorização para bloquear unilateralmente o lançamento de uma inteligência artificial.
Segundo a proposta, o órgão precisaria apresentar o caso à Justiça Federal dos Estados Unidos, especificamente ao Tribunal Distrital do Distrito de Columbia.
Caberia a um juiz examinar as evidências e decidir se o lançamento do modelo deveria ser interrompido.
O texto também procura limitar a atuação de outras autoridades federais, estabelecendo que nenhum outro departamento, agência ou órgão governamental poderia suspender o desenvolvimento, a implantação ou o uso interno do modelo com base no mecanismo proposto.
Essa estrutura busca combinar fiscalização de riscos extremos com maior previsibilidade jurídica para as empresas responsáveis pelo desenvolvimento de inteligência artificial.
Por outro lado, a concentração da autoridade de intervenção e a definição de critérios elevados podem gerar discussões sobre a capacidade de resposta diante de ameaças que não se enquadrem exatamente nas condições estabelecidas.
Anthropic afirma defender uma regulamentação baseada em riscos avançados
Em declaração citada pelo TechSpot, um representante da Anthropic afirmou que o documento reflete propostas apresentadas pela empresa em seu Advanced AI Framework, iniciativa que vem sendo discutida com legisladores estaduais e federais desde junho.
A companhia defende a adoção de políticas consideradas proporcionais aos riscos associados aos sistemas mais avançados, em vez de aplicar necessariamente as mesmas exigências a todas as ferramentas de inteligência artificial.
Essa distinção é relevante porque o setor reúne tecnologias com capacidades muito diferentes, desde assistentes destinados a tarefas cotidianas até modelos capazes de executar processos complexos, utilizar ferramentas externas e atuar com níveis crescentes de autonomia.
A proposta também surge em um momento de intensificação das discussões sobre segurança, responsabilidade corporativa e fiscalização da indústria de IA.
Regulamentação da inteligência artificial divide autoridades e empresas
Nos Estados Unidos, diferentes propostas procuram estabelecer mecanismos para acompanhar o desenvolvimento de sistemas de inteligência artificial considerados potencialmente perigosos.
Algumas iniciativas defendem restrições mais rigorosas para determinadas capacidades, enquanto outras priorizam compromissos voluntários das empresas e mecanismos de supervisão proporcionais aos riscos identificados.
O TechSpot também menciona propostas legislativas associadas ao senador Bernie Sanders, que defende restrições mais severas ao desenvolvimento de sistemas superinteligentes, além de iniciativas do governo Donald Trump baseadas em compromissos de segurança assumidos pela própria indústria.
Essas abordagens apresentam diferenças importantes sobre o papel do Estado, a responsabilidade dos desenvolvedores e as condições necessárias para interromper a disponibilização de tecnologias avançadas.
No centro da discussão está uma questão ainda sem consenso: qual nível de risco deve justificar a intervenção governamental antes que uma inteligência artificial cause danos concretos?
O desafio de equilibrar inovação e segurança
A proposta atribuída à Anthropic evidencia uma dificuldade crescente para os legisladores: estabelecer regras suficientemente claras para permitir a inovação tecnológica sem deixar de responder a ameaças relevantes.
Critérios objetivos, como limites financeiros e número de vítimas, podem proporcionar maior previsibilidade jurídica. Entretanto, também apresentam limitações, especialmente quando utilizados para avaliar riscos complexos cujas consequências são difíceis de estimar antecipadamente.
Além disso, os impactos potenciais da inteligência artificial não se restringem necessariamente a prejuízos econômicos imediatos ou danos físicos. Questões envolvendo privacidade, segurança da informação, discriminação algorítmica e utilização indevida de sistemas automatizados também fazem parte do debate regulatório mais amplo.
O documento apresentado pela Anthropic não representa uma legislação aprovada, mas uma proposta destinada à discussão com parlamentares norte-americanos. Seu conteúdo ainda poderá sofrer alterações ou sequer ser incorporado a um projeto de lei formal.
O debate, portanto, vai além dos números apresentados: trata-se de definir quem deve avaliar os riscos da inteligência artificial, quais evidências justificam uma intervenção e até onde deve ir a autoridade do governo sobre tecnologias que evoluem rapidamente.
À medida que os sistemas de IA se tornam mais capazes e autônomos, essas decisões poderão influenciar diretamente a forma como novas tecnologias serão desenvolvidas, avaliadas e disponibilizadas ao público.