Um entusiasta de homelab conseguiu executar o modelo Kimi K3, da Moonshot AI, com 2,8 trilhões de parâmetros usando um processador Xeon e módulos antigos de memória Intel Optane, sem uma placa gráfica dedicada para realizar a inferência. O experimento repercutiu em 8 de novembro de 2026 e tem todos os ingredientes de uma boa história de tecnologia: peças corporativas descontinuadas, um modelo gigantesco, ventiladores improvisados e desempenho que exige bastante paciência. O feito é real como demonstração de capacidade, mas não significa que qualquer PC doméstico agora possa substituir uma infraestrutura de IA moderna.
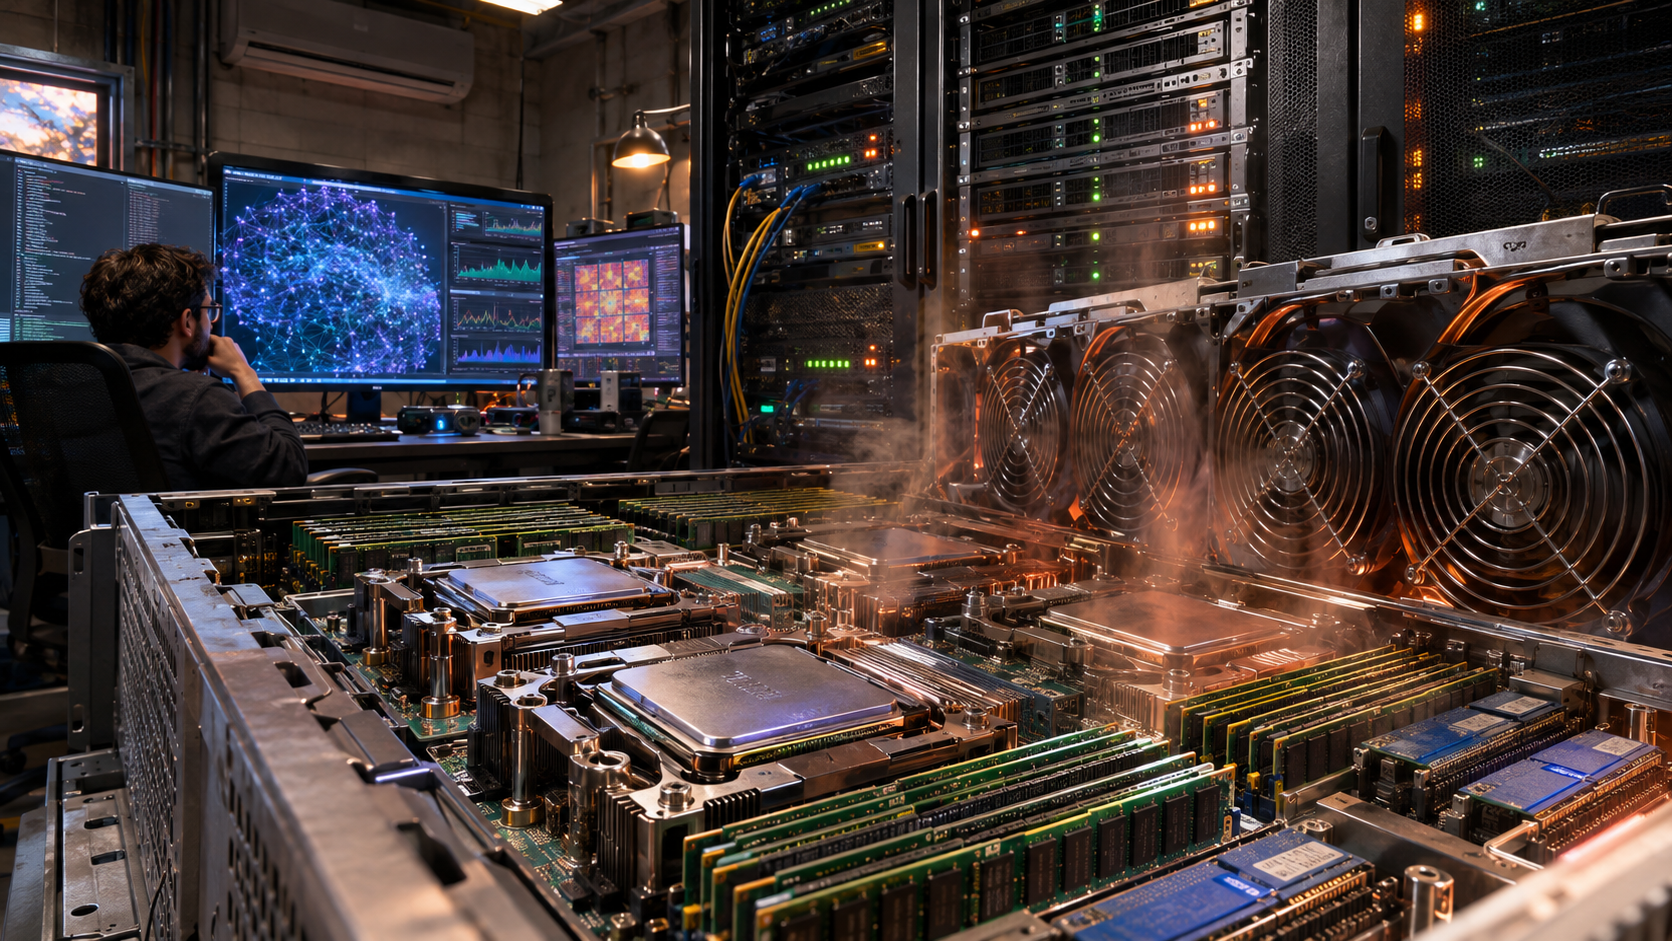
A montagem utiliza um Xeon Scalable de terceira geração com 40 núcleos e módulos Optane PMem 200, uma tecnologia de memória persistente pensada originalmente para servidores. Esses módulos cabem em slots de memória compatíveis e oferecem capacidade elevada a custo potencialmente interessante no mercado de usados. Entretanto, não são equivalentes a RAM DDR4 convencional, tampouco funcionam em qualquer placa-mãe. O controlador de memória, firmware e a configuração da plataforma precisam suportar o equipamento.
Uma prova de conceito, não um novo padrão de desempenho
Caber na memória é apenas a primeira etapa. Velocidade, ventilação e consumo continuam determinando se o experimento é útil.
Parâmetros totais do modelo
Velocidade relatada com quantização de 1 bit
Necessária para controlar calor dos módulos
Como colocar um modelo enorme em hardware usado
O Kimi K3 possui uma quantidade total de parâmetros impressionante, mas o número bruto não descreve sozinho o custo de cada resposta. Modelos com arquiteturas de especialistas podem ativar apenas parte de suas redes durante cada etapa de inferência. Ainda assim, é necessário armazenar os pesos e administrar a movimentação de dados. A experiência mostra uma maneira de encaixar esse volume usando memória persistente e quantização agressiva, em vez de tentar alocar tudo numa quantidade absurda de VRAM.
A quantização reduz a precisão usada para representar os pesos do modelo. Nesse teste, foram apresentadas configurações de um bit e três bits. Quanto menor a representação, mais fácil armazenar grandes quantidades de dados, mas maior pode ser o impacto na qualidade ou a complexidade de processamento. Não basta comparar dois números de bits e escolher o menor: é necessário testar a utilidade das respostas e o comportamento do software de inferência.
O resultado relatado foi aproximadamente 0,85 token por segundo na configuração de um bit e 0,75 token por segundo em três bits. São velocidades suficientes para demonstrar que o modelo funciona, porém lentas para uma conversa interativa confortável. Dependendo do tamanho da resposta, uma única interação pode exigir minutos de espera. É o tipo de montagem em que o orgulho técnico aparece muito antes da produtividade.
A velocidade relatada é inferior a um token por segundo. Não equivale a uma demonstração de inferência rápida em PC convencional.
Uma IA enorme cabe. E depois?
Parâmetros do modelo carregado por técnicas de quantização.
Resultado relatado para a execução em 1 bit, antes de ajustes finos.
Necessária para controlar o calor dos módulos Optane.
O calor da memória também entra na conta
O problema mais visível, no entanto, foi térmico. Módulos Optane de segunda geração foram desenhados para operar com fluxo de ar de servidores, diferente do que encontramos na maioria dos gabinetes domésticos. O responsável utilizou ventiladores sopradores ativos próximos às memórias para manter as temperaturas controladas. Segundo seu relato, sem resfriamento adequado o calor pode prejudicar até os módulos DRAM vizinhos.
Fabricantes especificam condições de ventilação e limites térmicos para esse tipo de componente. Isso significa que instalar Optane em um gabinete silencioso, sem avaliar circulação de ar, não é uma boa ideia. A carga prolongada de inferência pode manter os módulos trabalhando por muito tempo, produzindo calor de maneira contínua. O risco envolve estabilidade, desligamentos por proteção térmica e redução da confiabilidade do sistema.
Outro detalhe é o consumo de energia. Um processador de servidor com muitos núcleos, módulos persistentes e ventilação reforçada não se transforma automaticamente numa solução econômica só porque algumas peças usadas ficaram baratas. O custo total inclui placa compatível, fonte, refrigeração, eletricidade e manutenção. Quem se anima com a notícia precisa fazer contas antes de transformar a sala em um pequeno datacenter.
Existe uma diferença enorme entre caber na memória e funcionar bem. É possível carregar um modelo e obter respostas, mas a velocidade depende do acesso aos dados, da latência, do software, da arquitetura e de recursos disponíveis. Optane oferece capacidade e características interessantes para determinados cenários, mas não resolve por mágica a largura de banda que aceleradores modernos usam para processamento intensivo.
O autor pretende experimentar outras formas de distribuir trabalho entre memória e GPU e ajustar configurações de execução. Isso pode melhorar resultados, mas não existe garantia de que pequenos ajustes transformarão menos de um token por segundo em uma experiência fluida. O melhor valor do projeto, hoje, está em demonstrar alternativas técnicas e explicar suas limitações.
Para o público comum, a história não é uma recomendação de comprar Optane usado imediatamente. É um lembrete de que tecnologia descontinuada ainda pode servir a experimentos criativos quando alguém conhece profundamente seu funcionamento. E mostra que a engenharia de IA envolve compromissos entre capacidade, velocidade, qualidade e energia. Um resultado extraordinário no título pode esconder um cotidiano de muito ruído e calor.