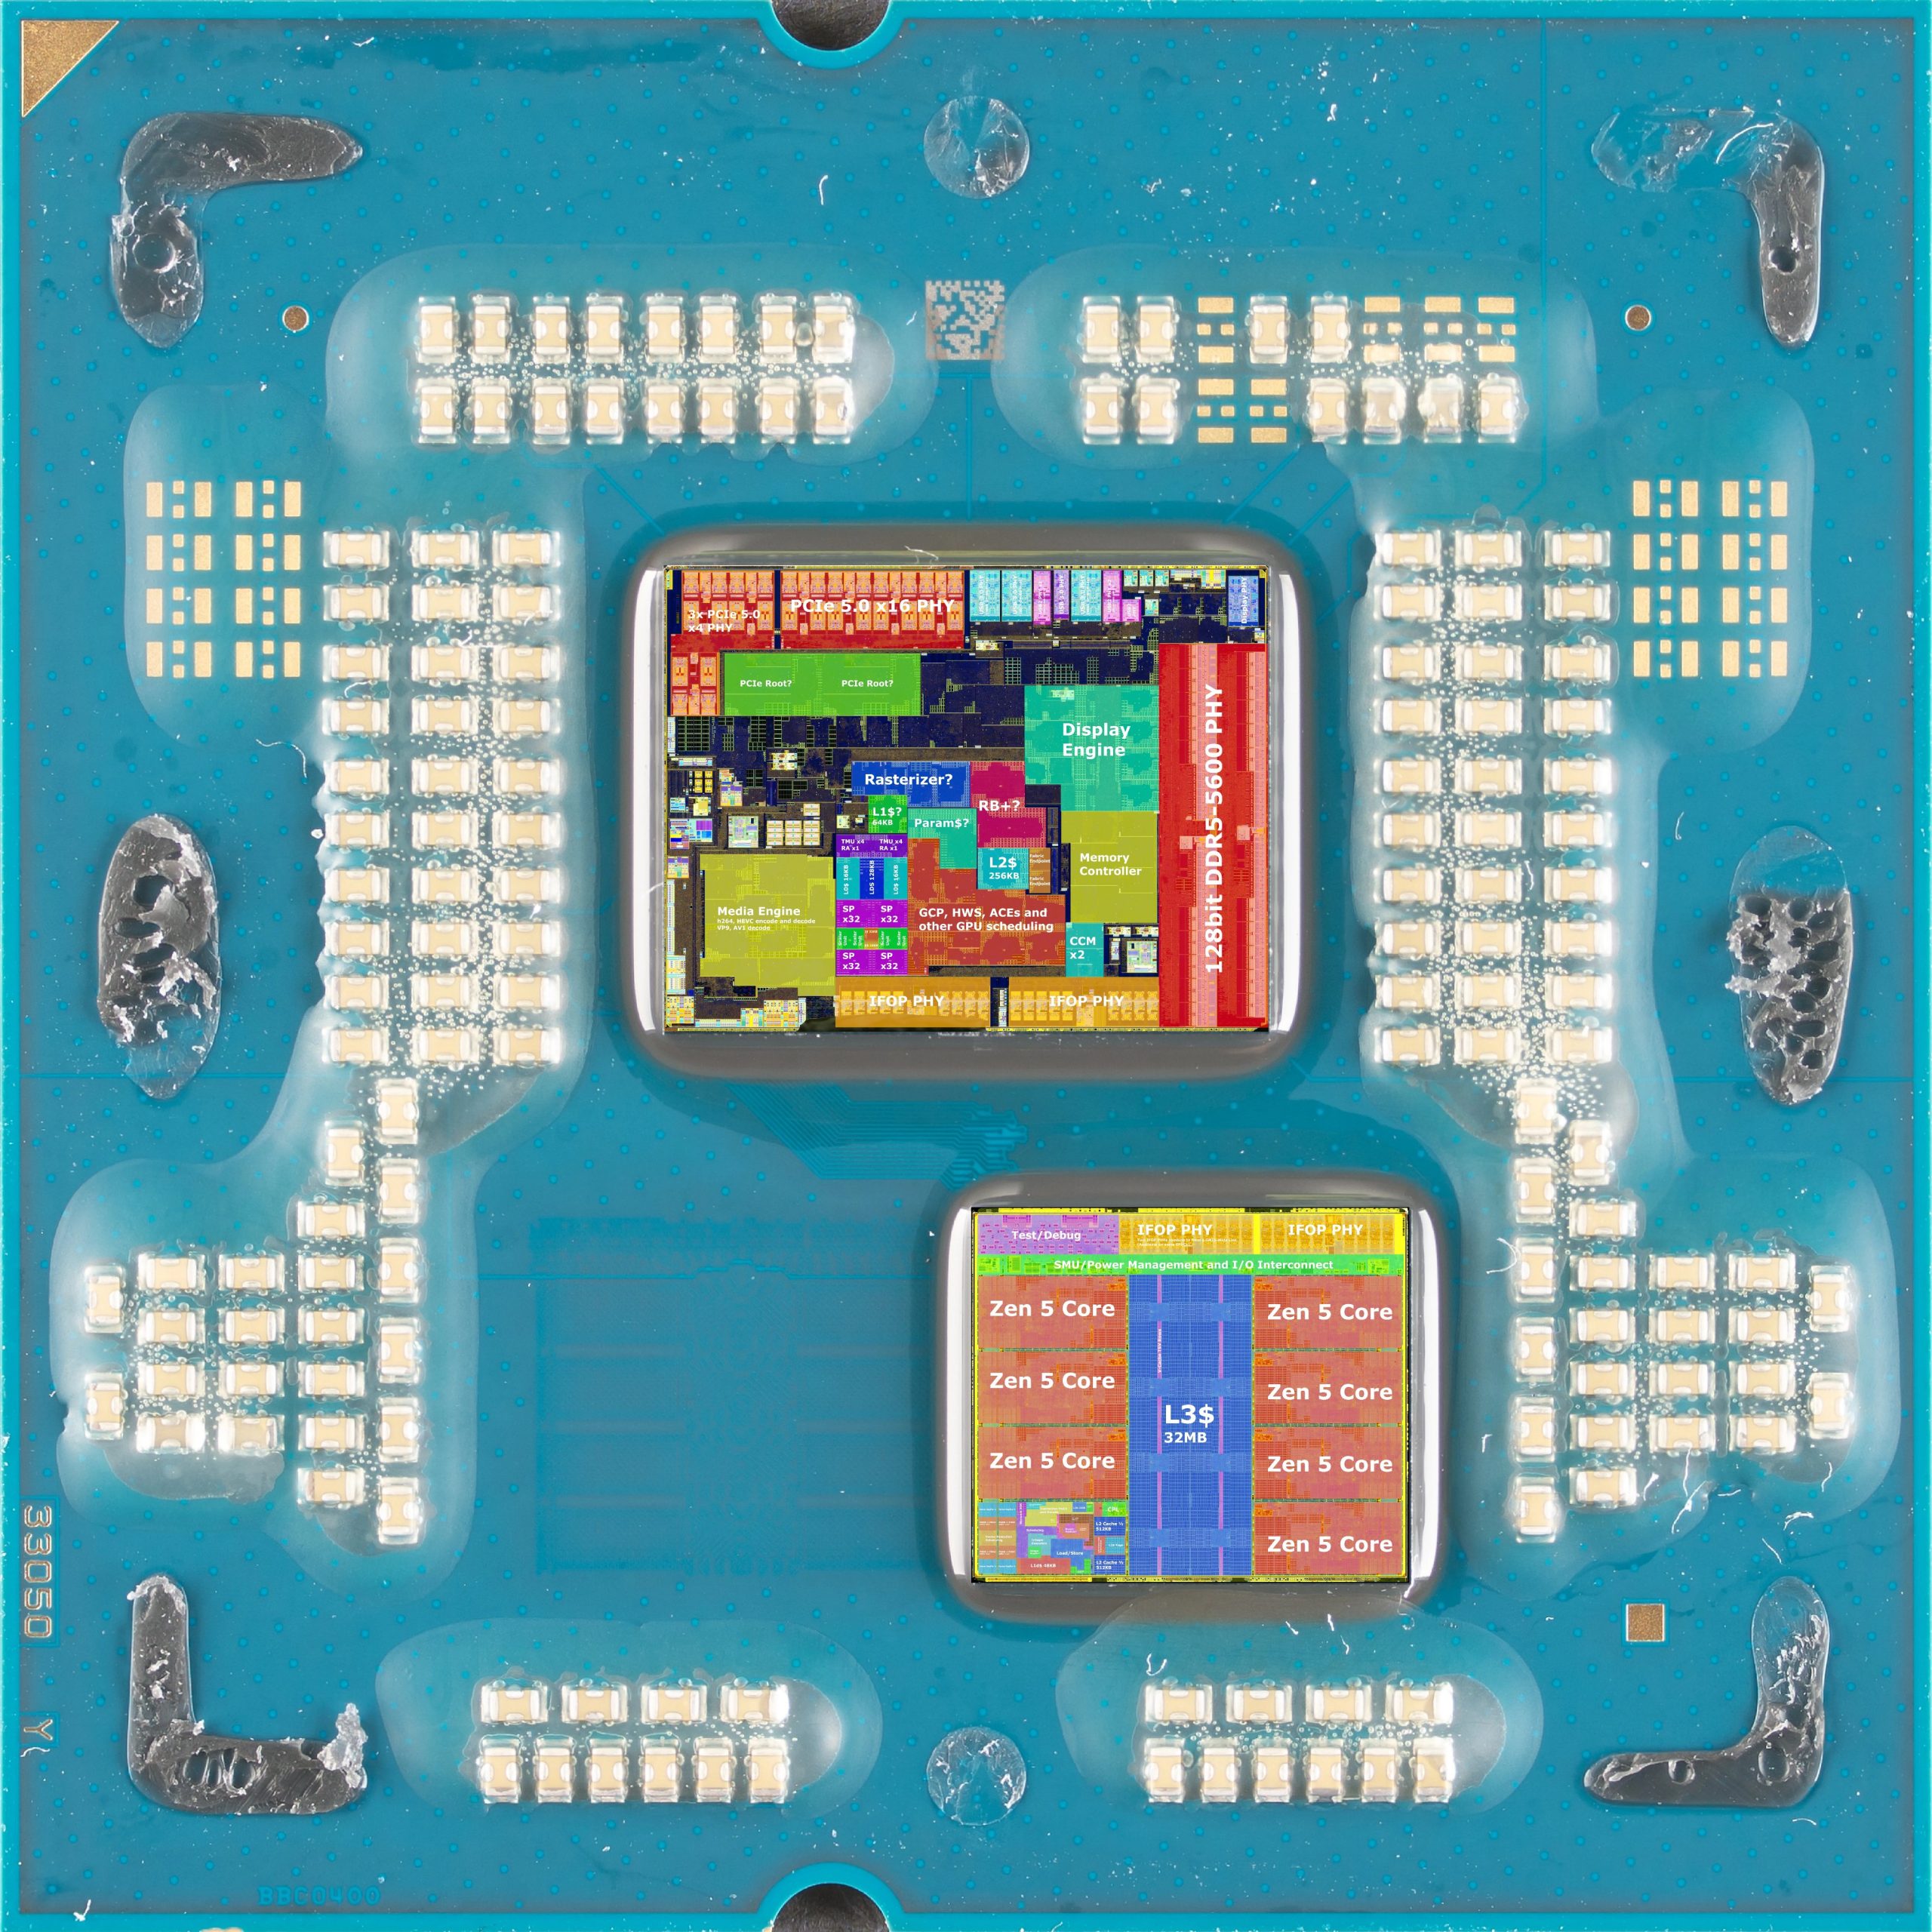
Uma otimização discreta no código de criptografia do Linux pode quase dobrar a velocidade de uma operação específica em processadores AMD Zen 5. O trabalho enviado para a versão 7.5 do kernel atualiza o caminho AVX-512 utilizado pelo algoritmo ChaCha, permitindo que certos chips processem mais blocos de dados por passagem. Os testes divulgados pelo desenvolvedor registraram ganhos de até 99% em uma máquina Ryzen AI Max com arquitetura Zen 5. Em Zen 4, o salto relatado chegou a 39%.
É uma notícia técnica importante, mas não significa que todo computador com Linux ficará 99% mais rápido. Os números descrevem uma rotina de criptografia sob condições específicas, e a alteração ainda estava em preparação para a janela de integração do Linux 7.5. A presença do patch em um ramo de desenvolvimento não equivale à disponibilidade em todas as distribuições nem assegura que ele chegará sem alterações à versão final.
Ganho medido na implementação ChaCha em AMD Zen 5 com AVX-512 de 512 bits.
O que o algoritmo ChaCha faz dentro de um sistema
ChaCha é um algoritmo de criptografia de fluxo usado em diferentes contextos para transformar dados de forma rápida e segura quando implementado corretamente. Em conjunto com mecanismos de autenticação e protocolos adequados, criptografia baseada em ChaCha ajuda a proteger informações transmitidas ou armazenadas. O kernel Linux mantém implementações otimizadas para diferentes arquiteturas e extensões de instruções, tentando tirar proveito da capacidade real do processador.
Há um detalhe importante: nem todo aplicativo que usa ChaCha executa exatamente a mesma função do kernel. Softwares podem incluir bibliotecas próprias, caminhos criptográficos diferentes e suporte específico a hardware. O ganho apresentado não autoriza afirmar que toda conexão VPN, aplicativo de mensagens ou transferência SSH terá uma melhoria do mesmo tamanho. É preciso testar cada percurso real de dados.
Por que AVX-512 já foi um problema de desempenho
AVX-512 é uma família de instruções vetoriais que permite realizar operações com vários elementos em paralelo. Em processadores mais antigos, especialmente determinadas gerações Intel Skylake-X, utilizar unidades vetoriais largas podia reduzir a frequência de operação da CPU. Por isso, engenheiros frequentemente escolhiam executar operações em vetores de 256 bits para manter um equilíbrio entre volume processado e consumo de energia.
Essa precaução permaneceu em caminhos de software mesmo depois de novas arquiteturas reduzirem ou eliminarem os custos mais severos de frequência. O patch de Martin Willi, desenvolvedor também ligado ao projeto strongSwan, revisa essa escolha e permite que processadores modernos utilizem registros de 512 bits quando o hardware e o despacho da rotina considerarem adequado. A consequência é aumentar a quantidade de blocos manipulados em uma única iteração.
Como a implementação decide qual caminho utilizar
O patch mantém mecanismos de seleção de instruções compatíveis com a arquitetura da máquina. Um controle interno associado à preferência por registradores YMM ajuda a escolher entre caminhos vetoriais conforme o hardware. Esse tipo de despacho é fundamental em um sistema operacional que precisa rodar desde máquinas antigas até servidores atuais, sem obrigar o usuário a selecionar manualmente funções criptográficas.
Se uma rotina passa a assumir capacidades que um processador não possui, o resultado pode ser incompatibilidade ou execução incorreta. Por isso, a otimização precisa preservar o comportamento anterior para CPUs que não atendam aos requisitos. Os ganhos máximos observados em Zen 5 dependem do aproveitamento de um caminho de dados completo de 512 bits, enquanto certas máquinas Zen 4 utilizam duas operações vetoriais de 256 bits internamente.
O que muda para quem administra servidores
Em cenários que processam grandes quantidades de dados criptografados, reduzir o custo de CPU pode liberar recursos para outras tarefas. É especialmente interessante em ambientes de rede, criptografia de armazenamento e serviços com muitas sessões simultâneas, desde que as aplicações utilizem o caminho beneficiado. A melhoria também pode alterar consumo por operação e comportamento térmico, aspectos que exigem medições específicas.
O número de 99% é o melhor resultado registrado em uma avaliação localizada. Para medir impacto em produção, seria necessário executar benchmarks representativos, observar latência, uso de CPU, eficiência energética e validar que os dados são processados corretamente. Uma otimização de criptografia não substitui políticas de autenticação, atualizações de segurança ou arquitetura bem configurada.
Quando a atualização chega
A mudança foi colocada no ramo de desenvolvimento destinado ao código criptográfico e deverá ser encaminhada para a janela de integração do Linux 7.5. O calendário exato depende da manutenção do kernel, revisão técnica e testes. Distribuições como Ubuntu, Fedora e Debian também escolhem seus próprios ciclos, e uma versão do kernel upstream não aparece automaticamente em servidores de produção.
Para administradores que dependem de estabilidade, a orientação continua sendo avaliar a versão disponibilizada e suportada pela distribuição. Compilar um kernel experimental somente para obter um resultado de benchmark não costuma ser uma troca razoável em sistemas críticos. A evolução merece acompanhamento porque demonstra como detalhes de engenharia podem produzir ganhos reais sem mudar o hardware.