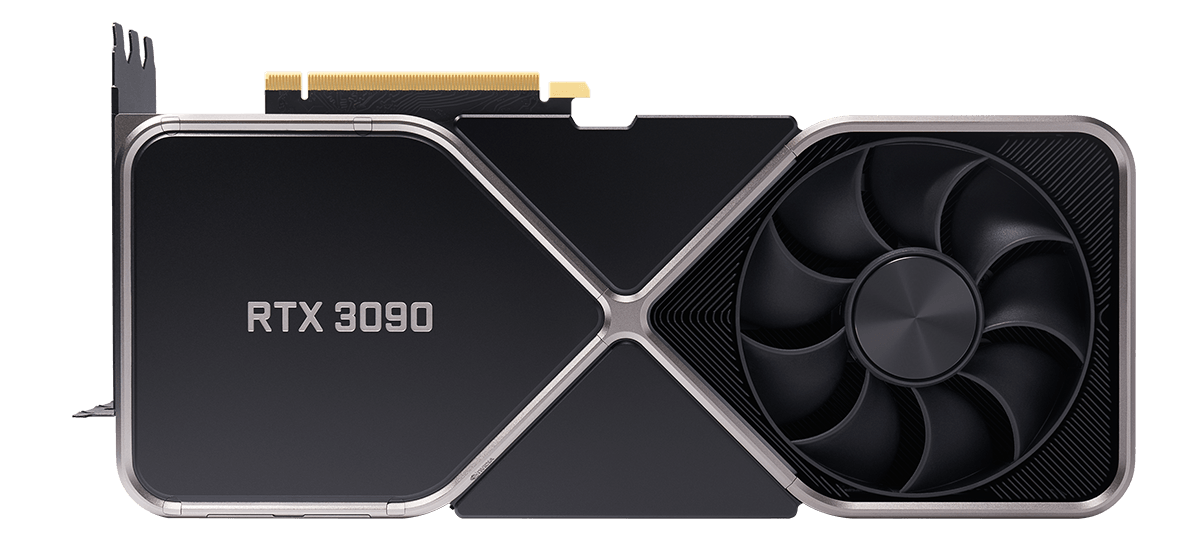
A GeForce RTX 3090 foi lançada em 2020, mas continua aparecendo em experimentos de inteligência artificial por uma razão simples: seus 24 GB de memória gráfica ainda são úteis para quem deseja executar modelos localmente. O projeto NInfer-3090, desenvolvido para explorar agressivamente a arquitetura da placa, publicou resultados que ultrapassam 300 tokens por segundo em determinadas tarefas e chegam perto de 400 em testes especialmente favoráveis. São números impressionantes para hardware antigo, mas exigem contexto técnico. Não significa que qualquer chatbot passará automaticamente a responder nessa velocidade.
O sistema descrito pelos desenvolvedores utiliza C++ e CUDA, com estratégias de execução projetadas especificamente para placas com arquitetura GA102. Também incorpora decodificação especulativa, técnicas de reutilização de padrões e formatos compactos de memória. Em vez de ser um programa universal que aceita qualquer modelo disponível, a proposta concentra-se em famílias e configurações determinadas de Qwen. Essa especialização ajuda a explicar os resultados, mas também limita o alcance de manchetes sobre um suposto milagre aplicável a todas as cargas de trabalho.
Uma medição divulgada pelo repositório aponta aproximadamente 399 tokens por segundo sustentados numa carga de saída estruturada e repetitiva, enquanto uma execução favorável ultrapassou 406. Em outra tarefa de refatoração de código, mais exigente, a velocidade relatada ficou próxima de 310. Os próprios desenvolvedores mostram variações entre cenários. Esses valores são resultados publicados pelo projeto, não certificação independente de que a placa terá o mesmo desempenho em todas as máquinas, sistemas operacionais ou condições de geração.
DADOS DIVULGADOS PELO PROJETO · NINFER-3090
Uma GPU, cargas muito diferentes
Valores reportados pelos desenvolvedores, não auditoria independente. Escala de barras em tokens por segundo; limite gráfico de 420.
Os ganhos dependem de modelo, implementação e previsibilidade do texto; não se aplicam automaticamente a jogos ou a qualquer IA.
A principal inovação de certas configurações não está em fazer a placa calcular cada token tradicional mais rápido, mas em propor vários tokens de uma vez e verificar se eles estão corretos. Quando a previsão funciona, a saída avança mais depressa. Quando falha, parte do trabalho especulativo é descartada. Textos previsíveis e estruturados favorecem esse método, enquanto tarefas que exigem escolhas menos óbvias podem reduzir os ganhos. É por isso que dois benchmarks com o mesmo hardware podem parecer provenientes de gerações completamente distintas.
O consumo de memória também merece atenção. Os modelos e formatos citados utilizam quantização e técnicas para encaixar pesos e estruturas auxiliares nos limites da VRAM. Reduzir precisão pode ampliar viabilidade de execução, mas exige avaliar consequências para qualidade, estabilidade e compatibilidade. A comparação correta inclui configuração completa do modelo, tamanho de contexto, comprimento das respostas, consumo energético e critérios de verificação. Sem essas informações, tokens por segundo vira uma métrica tão facilmente manipulável quanto FPS de videogame.
Executar IA local oferece vantagens legítimas. Dados podem permanecer sob controle do operador, certas tarefas continuam funcionando sem depender de conexão externa e os custos de chamadas de APIs podem ser substituídos por investimento em equipamento e eletricidade. Mas isso não significa custo zero ou garantia de privacidade automática. Sistemas precisam de atualizações, proteção dos arquivos e revisão das ferramentas às quais modelos recebem acesso. Uma IA executada em casa também pode produzir erros, sugestões perigosas ou resultados incorretos.
O projeto é especialmente interessante para entusiastas que já possuem uma RTX 3090. Comprar equipamento novo para buscar uma taxa específica de tokens pode ser precipitado, pois a eficiência depende do perfil de uso. Quem processa muitos pedidos simultâneos encontra desafios diferentes de quem deseja uma única resposta longa. Quem precisa de visão computacional ou contextos enormes também pode enfrentar limitações ausentes em benchmarks de texto. A especialização do NInfer deve ser tratada como característica técnica, não como deficiência moral.
Há um componente de preservação tecnológica nessa história. Placas gráficas antigas frequentemente perdem prestígio no mercado de jogos quando novas gerações chegam, mas podem continuar úteis em computação científica e inferência. Projetos comunitários descobrem combinações de kernels e formatos que fabricantes não priorizam. Isso prolonga a vida econômica do hardware e reduz parte da pressão por substituição constante. Ao mesmo tempo, soluções altamente otimizadas para uma configuração específica podem exigir mais conhecimento técnico para instalar e manter.
Para leitores interessados em experimentar, o primeiro passo é consultar requisitos, modelos suportados e metodologia de benchmark. Não convém baixar executáveis de fontes desconhecidas ou presumir compatibilidade com qualquer checkpoint. Também vale medir uma tarefa real do próprio fluxo de trabalho, em vez de selecionar números de uma demonstração feita para favorecer determinada técnica. Desempenho é significativo quando mantém qualidade suficiente para produzir resultados úteis.
Veredicto GeekZilla
NInfer-3090 demonstra o valor de otimização profunda e o quanto ainda pode ser extraído de hardware conhecido. É uma notícia promissora para IA local, mas não prova que uma GPU de 2020 superou universalmente soluções mais modernas. O resultado espetacular pertence a condições cuidadosamente especificadas. A parte mais interessante é lembrar que inovação não acontece apenas quando alguém vende uma placa nova: às vezes ela surge quando alguém aprende a utilizar muito melhor a antiga.